
Varians og standardavvik for et utvalg måler hvor mye verdiene i datasettet typisk avviker fra gjennomsnittet. Utvalgsvariansen regnes ut ved å summere de kvadrerte avvikene fra gjennomsnittet og dele på n−1, mens standardavviket er kvadratroten av variansen og har samme enhet som dataene dine.
Hva er varians og standardavvik for et utvalg?
For å vite hva varians og standardavvik for et utvalg er for noe, må vi først forklare hva et utvalg er. Et utvalg er rett og slett noen utvalgte objekter eller tall fra en populasjon/gruppe. Et enkelt eksempel er å velge 8 tilfeldige studenter ved NTNU og spørre dem hvor mange timer i uka de ser på serier. Tallene de svarer er utvalget vårt, og dette kan vi bruke til å finne varians og standardavvik for utvalget. Dette kalles også empirisk varians og empirisk standardavvik (empirisk = «erfaringsmessig»).
La oss si de 8 studentene svarer:
| 9 | 5 | 7 | 8 | 4 | 7 | 6 | 3 |
De fleste av tallene ligger rundt 6 og det er ingen som ser veldig mye eller veldig lite på serier. Det er altså litt variasjon i tallene, men ikke veldig mye.
La oss heller si at de 8 studentene svarer:
| 10 | 4 | 8 | 9 | 0 | 15 | 6 | 2 |
I dette tilfellet er det mye større variasjon, og det er tall helt fra 0 til 15. For å forklare variasjon i hverdagen så fungerer uttrykkene «stor variasjon» og «lite variasjon» helt greit. I statistikk derimot, er det ofte behov for å sette tall på hvor stor denne variasjonen er. Til dette brukes begrepene varians og standardavvik!
Utvalg eller populasjon?
Denne artikkelen bruker et utvalg til å estimere variansen i en større populasjon. Da deler vi på n−1. For et tilfeldig utvalg av uavhengige observasjoner fra samme populasjon gir dette et forventningsrett estimat av populasjonsvariansen. Vi trenger minst to observasjoner. Hvis formålet bare er å beskrive spredningen i hele datasettet vi har, kan vi dele på n. Alle elevene i én klasse er bare en hel populasjon dersom det nettopp er den klassen vi vil beskrive. Formelen med n er forklart i artikkelen Hva er standardavvik og varians?
Regne ut varians
Utvalgsvarians kalles ofte for S^2. Formelen for å regne det ut er
S^2=\frac{1}{n-1}\sum_{i=1}^n(x_i-\bar{x})^2I denne formelen så er
- n antall tall i utvalget, og kalles ofte antall observasjoner
- x_i er hvert av tallene, altså hver observasjon
- \bar{x} er gjennomsnittet av alle observasjonene
Eksempel 1
I det første eksempelet fra i stad svarte de 8 studentene
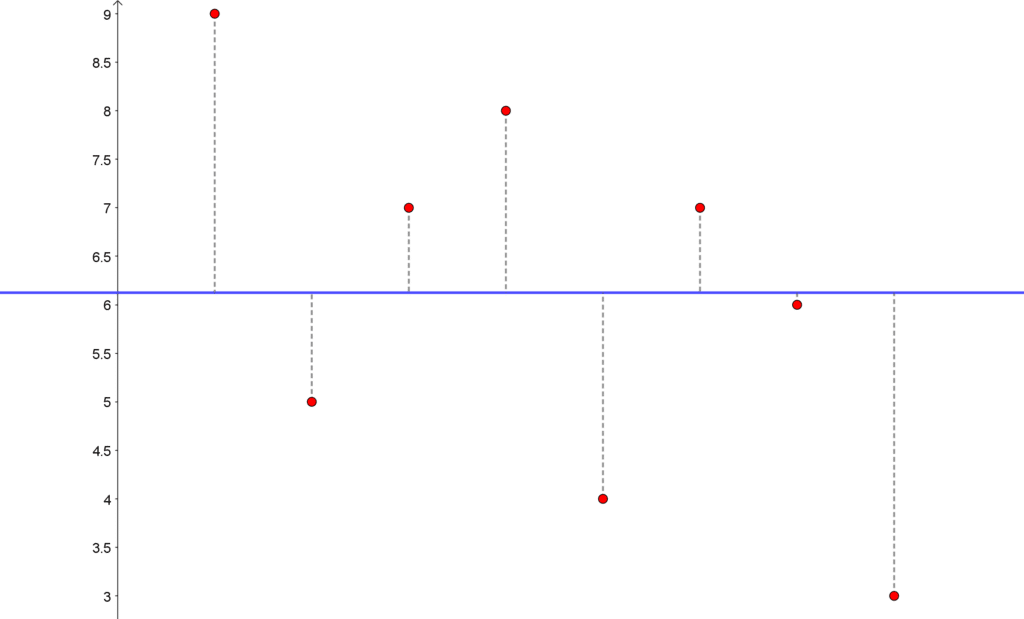
9, 5, 7, 8, 4, 7, 6, 3
La oss regne ut variansen for dette utvalget. Først så må vi finne gjennomsnittet \bar{x}:
Før vi regner ut variansen, så kan vi studere dette i et koordinatsystem. Hver av de 8 observasjonene er plassert i et koordinatsystem, og gjennomsnittet er den blå linjen. Det som summeres opp i variansen er avstanden mellom observasjonene og linjen for gjennomsnittet, opphøyd i andre.
Nå er det bare å regne ut variansen:
\begin{aligned}S^2=\frac17\big[&(9-6{,}125)^2+(5-6{,}125)^2\\&+(7-6{,}125)^2+(8-6{,}125)^2\\&+(4-6{,}125)^2+(7-6{,}125)^2\\&+(6-6{,}125)^2+(3-6{,}125)^2\big]\\=\frac{28{,}875}{7}&=4{,}125\end{aligned}Den empiriske variansen, eller variansen til utvalget, er altså 4,125.
La oss se hva den blir i det andre tilfellet.
Eksempel 2
De alternative svarene fra de 8 studentene var
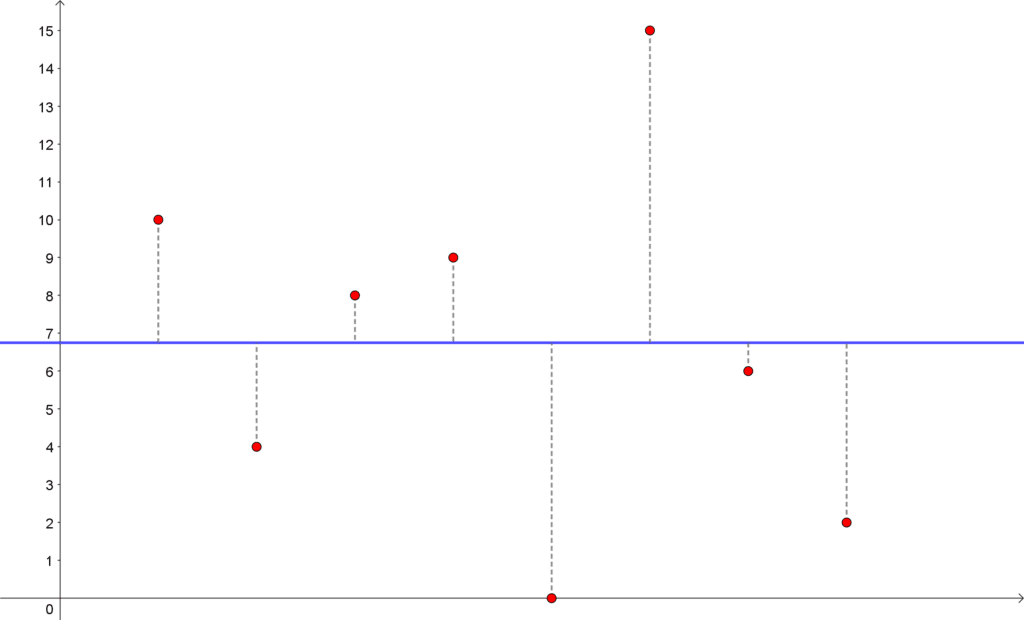
10, 4, 8, 9, 0, 15, 6, 2
La oss regne ut variansen for dette utvalget. Først så må vi igjen finne gjennomsnittet \bar{x}:
Vi kan skissere dette grafisk igjen, og hvis man ser på de to grafene er det tydelig at avstandene mellom gjennomsnittet og observasjonene er mye større i dette eksempelet, og dermed blir variansen også mye større!
Gjennomsnittet er ikke så langt fra hva det var i eksempel 1, men la oss se hva variansen blir:
\begin{aligned}S^2=\frac17\big[&(10-6{,}75)^2+(4-6{,}75)^2\\&+(8-6{,}75)^2+(9-6{,}75)^2\\&+(0-6{,}75)^2+(15-6{,}75)^2\\&+(6-6{,}75)^2+(2-6{,}75)^2\big]\\=\frac{161{,}5}{7}&\approx23{,}071\end{aligned}Variansen i dette tilfellet er mye større!
Benevning for varians
Når variansen regnes ut så bruker man kvadratet (opphøyd i 2) av differansen mellom observasjoner (x_i) og gjennomsnitt (\bar{x}). Siden det er opphøyd i to blir også benevningen til variansen opphøyd i 2. I disse eksemplene ser vi på antall timer studenter bruker på serier. Benevningen til tallene i utvalget er altså timer. Benevningen til variansen er derfor timer2. I siste eksempelet er variansen 23,071~timer^2. Timer opphøyd i 2 gir lite mening, men heldigvis så har man uttrykket standardavvik der dette problemet forsvinner.
Regne ut standardavvik
Det å regne ut standardavviket er veldig lett hvis du allerede har regnet ut variansen. Definisjonen av et utvalgs standardavvik er
S=\sqrt{S^2}Standardavviket er kvadratroten av variansen og beskriver hvor mye observasjonene typisk varierer rundt gjennomsnittet. Det har samme enhet som dataene, for eksempel timer.
Her finner vi standardavviket ved å ta kvadratroten av variansen vi allerede har beregnet. La oss se på de to eksemplene.
Eksempel 1
I det første eksempelet fra i stad svarte de 8 studentene
9, 5, 7, 8, 4, 7, 6, 3
Variansen til dette utvalget er S^2=4,125.
Standardavviket er
Eksempel 2
I det andre eksempelet fra i stad svarte studentene
10, 4, 8, 9, 0, 15, 6, 2
Variansen fant vi at er S^2=23,071.
Standardavviket er
Notasjon for varians og standardavvik
I dette blogginnlegget har vi brukt notasjonene
- Empirisk varians: S^2
- Empirisk standardavvik: S
Hvilken notasjon som brukes varierer litt, og noen bruker små s-er slik som dette:
- Empirisk varians: s^2
- Empirisk standardavvik: s
Med subskriptx,y
I noen tilfeller har du kanskje en rekke observasjoner kalt x_i og noen andre kalt y_i. Hvis du skal regne ut variansen til x-ene og y-ene er det lurt å skille mellom hvilken S^2 som tilhører x og hvilken som tilhører y. Da brukes ofte en subskript på variansen og standardavviket. For x ville man i så fall skrevet noe som dette
- Empirisk varians: S^2_x
- Empirisk standardavvik: S_x
Varians og standardavvik for en stokastisk variabel
I forbindelse med statistikk har du kanskje hørt om stokastiske variabler? I så fall er det naturlig å møte på uttrykkene:
- Var[X]
- Std[X]
Dette er henholdsvis varians og standardavvik til en stokastisk variabel X. Disse størrelsene er noe annet enn S^2 og S. Du kan lære mer om slike stokastiske variabler og deres varians i våre statistikk-kurs på enkeleksamen.no.
På enkeleksamen.no finner du en rekke fag i Statistikk og Statistikk for økonomer tilpasset skoler og universiteter rundt om i Norge. I kursene har du mulighet til å se videoer, gjøre quizzer og få hjelp av våre supre nettlærere!
Vil du se beregningen forklart på video? Se leksjonen Mål på spredning: varians og standardavvik i kurset Psykologisk forskningsmetode for NTNU (PSY1111 og PSYK4111).
Kort oppsummert
Utvalgsvariansen beregnes ved å summere de kvadrerte avvikene fra gjennomsnittet og dele på n−1. Standardavviket er kvadratroten av variansen og har samme enhet som dataene. Har du hele populasjonen og bare vil beskrive den, deler du på n.
Ofte stilte spørsmål
Hva er forskjellen på varians og standardavvik?
Hvorfor deler man på n−1 og ikke n?
Kan standardavviket være negativt?
Hva regnes som et «stort» standardavvik?
Finn ditt Statistikk for økonomer-fag tilpasset ditt studiested
Standardavviket er også nøkkelen til å tolke normalfordelingen.

MET 2920
Statistikk for økonomer

MET2
Statistikk for økonomer – NHH

MET 3431
Statistikk

MET 1190
Statistikk (siviløkonom)

ØKA1026, 3MET130, SMET130, HMET130
Statistikk for økonomer – Universitetet i Innlandet

BØA115
Statistikk for økonomer – HVL

SFO1100
Statistikk for økonomer – Kristiania

SØK1004, REA1154, AR100219, MET1002
Statistikk for økonomer – NTNU

MET1010
Statistikk for økonomer – USN

HSM103
Statistikk – NLA Høgskolen

ØAMET1100
Statistikk – OsloMet