
Normalfordelingen er en sannsynlighetsmodell med en symmetrisk, klokkeformet kurve. Verdiene samler seg rundt gjennomsnittet, mens standardavviket beskriver spredningen. For å vurdere om modellen passer til et datasett, kan du begynne med et histogram.
Start med histogrammet
Et histogram grupperer tallverdier i intervaller og viser hvor ofte verdier i hvert intervall forekommer. Med like brede intervaller viser høyden på søylene antall eller andel observasjoner. Formen gir en første oversikt over:
- Hvor verdiene samler seg, altså sentraltendensen
- Hvor stor spredningen er
- Om fordelingen er symmetrisk eller skjev
Tenk deg to konstruerte datasett med gjennomsnittsalder 40 år. I det ene er de fleste rundt 40. I det andre er det både mange unge og mange eldre. Gjennomsnittet er likt, men spredningen er forskjellig.
Samme sentraltendens, helt ulik spredning. Det er derfor gjennomsnittet alene sjelden er nok.
Unimodale og bimodale fordelinger
En fordeling med én topp kalles unimodal. En fordeling med to topper kalles bimodal.
To topper kan tyde på at ulike grupper er blandet, særlig hvis gruppene har klart forskjellige typiske verdier. Det er ikke et sikkert bevis: valg av intervaller i histogrammet kan også påvirke formen. Undersøk derfor både dataene og hvordan histogrammet er laget.
Hva kjennetegner normalfordelingen?
En normalfordeling har disse egenskapene:
- Den er symmetrisk. Kurven faller like mye på begge sider av gjennomsnittet.
- Gjennomsnitt, median og typetall faller sammen i samme punkt, midt på kurven.
- Områder nær gjennomsnittet har større sannsynlighet enn like brede områder langt ute i halene.
- Halene tar aldri helt slutt. Kurven nærmer seg x-aksen uten å treffe den.
Formen har gitt fordelingen kallenavnet the bell curve, fordi den ligner en kirkeklokke.
Normalfordelingen beskrives av to tall, kalt parametere: μ er forventningsverdien, eller gjennomsnittet i modellen. σ er standardavviket og må være større enn null. Et større standardavvik gir en bredere og lavere kurve. Hele arealet under kurven er 1, og arealet mellom to verdier er sannsynligheten for å havne i dette intervallet.
Her er standardavviket en parameter i modellen. Har du et konkret datasett, kan du i stedet beregne varians og standardavvik for et utvalg.
68-95-99,7-regelen
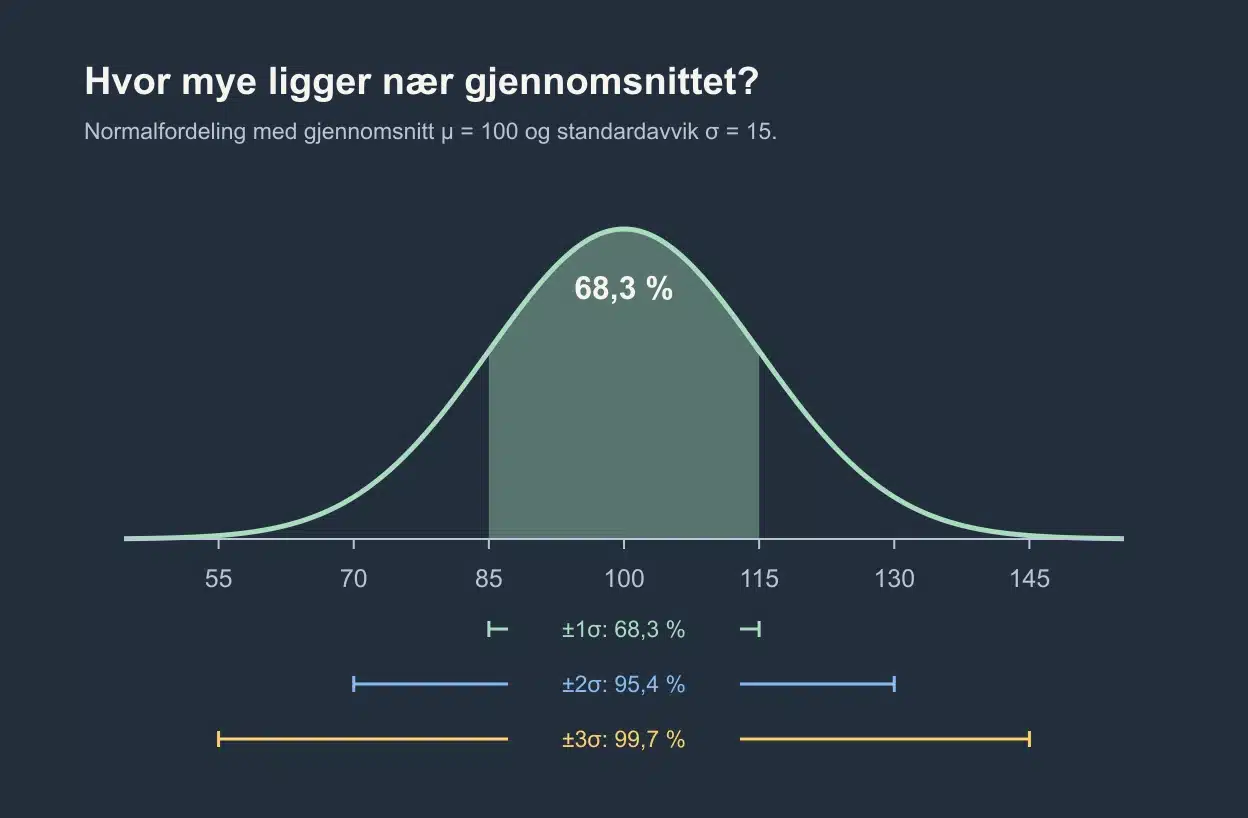
For en normalfordelt variabel gjelder disse omtrentlige andelene:
- Omtrent 68 prosent av observasjonene ligger innenfor ett standardavvik fra gjennomsnittet
- Omtrent 95 prosent ligger innenfor to standardavvik
- Omtrent 99,7 prosent ligger innenfor tre standardavvik
Anta at en testskår er normalfordelt med gjennomsnitt 100 og standardavvik 15. Da ligger omtrent 68 prosent mellom 100 − 15 = 85 og 100 + 15 = 115. Omtrent 95 prosent ligger mellom 70 og 130. Dette er et modelleksempel, ikke en regel for alle typer testresultater.
Hva er tilnærmet normalfordelt?
Høyde i en relativt ensartet gruppe og enkelte typer målefeil kan ofte beskrives omtrent med en normalfordeling. Det betyr ikke at alle biologiske mål eller alle datasett følger denne modellen. Se på dataene før du velger fordeling.
Normalfordelingen er en tilnærming til virkelige data. Høyde kan for eksempel ikke være negativ, mens modellen tillater alle reelle tall. Spørsmålet er om tilnærmingen er god nok for det du skal bruke den til.
Skjeve fordelinger
Ikke alle datasett er symmetriske.
En venstreskjev fordeling har en lengre hale mot lave verdier. En lett prøve kan for eksempel gi mange høye poengsummer og noen få lave.
En høyreskjev fordeling har en lengre hale mot høye verdier. Et tenkt inntektsdatasett med mange moderate inntekter og noen få svært høye inntekter er et eksempel.
Ekstreme verdier påvirker gjennomsnittet mer enn medianen. I mange skjeve datasett kan medianen derfor gi et mer nyttig bilde av en typisk verdi. Vurder både form, spredning og hva tallene skal brukes til.
Hvorfor gjennomsnitt ofte blir normalfordelte
Sentralgrenseteoremet sier, under bestemte forutsetninger, at fordelingen av utvalgsgjennomsnitt nærmer seg en normalfordeling når utvalgsstørrelsen øker. En vanlig versjon gjelder uavhengige observasjoner fra samme fordeling med endelig forventningsverdi og varians. Hvor stort utvalg som trengs for en god tilnærming, avhenger av den opprinnelige fordelingen.
Teoremet brukes blant annet i metoder for å beregne usikkerheten i et estimert gjennomsnitt, som konfidensintervaller for gjennomsnitt. Det er fordelingen av gjennomsnittene som kan bli tilnærmet normal, ikke nødvendigvis de enkelte observasjonene. Du må fortsatt sjekke forutsetningene for metoden du bruker.
Kort oppsummert
Normalfordelingen er symmetrisk og bestemmes av gjennomsnitt og standardavvik. Omtrent 68, 95 og 99,7 prosent ligger innenfor henholdsvis ett, to og tre standardavvik fra gjennomsnittet. Et histogram hjelper deg å se formen på dataene, men ikke alle datasett passer til en normalfordeling.
Se forklaringen på video
Vil du se temaet forklart? Åpne videoleksjonen «Normalfordeling» i EnkelEksamen. Du må logge inn, og enkelte leksjoner krever tilgang til faget.
Vil du jobbe videre med faget? Se innholdet i Statistikk ved NTNU, eller finn faget som passer til ditt studiested.

TMA4245, TMA4240
Statistikk – NTNU