
Et konfidensintervall for gjennomsnittet viser usikkerheten i et estimat av populasjonsgjennomsnittet. Et 95 prosent konfidensnivå betyr at metoden over mange nye utvalg gir intervaller som inneholder det sanne gjennomsnittet i omtrent 95 prosent av tilfellene. Vi bruker Z-fordelingen ved kjent populasjonsstandardavvik og t-fordelingen når dette må estimeres, under forutsetningene nedenfor.
Hva er et konfidensintervall?
Et konfidensintervall beregnes fra et utvalg og gir en nedre og en øvre grense for en ukjent populasjonsparameter. Her undersøker vi populasjonsgjennomsnittet, skrevet som \mu (my). Intervallet viser usikkerheten som følger av at vi bare har observert et utvalg.
Konfidensnivået skrives ofte som (1-\alpha)\cdot100 prosent. Velger vi 95 prosent, er \alpha=0{,}05. Nivået beskriver hvor stor andel av intervallene som vil inneholde det sanne gjennomsnittet ved mange gjentatte utvalg, når forutsetningene er oppfylt.
Bredden på intervallet sier noe om presisjonen: et smalt intervall gir et mer presist estimat enn et bredt, gitt samme metode og konfidensnivå.
Den viktigste tolkningen: hva betyr 95 prosent konfidens?
95 prosent er ikke sannsynligheten for at et fast populasjonsgjennomsnitt ligger i akkurat det intervallet vi allerede har beregnet. I denne statistiske modellen er gjennomsnittet et fast, ukjent tall. Det beregnede intervallet inneholder tallet, eller gjør det ikke. Derfor må uttrykket «95 prosent sikker» forklares med metoden over gjentatte utvalg.
Konfidensnivået beskriver i stedet metoden: dersom vi trakk mange utvalg og regnet ut et konfidensintervall for hvert av dem, ville omtrent 95 prosent av alle intervallene inneholde det sanne gjennomsnittet, når forutsetningene for metoden er oppfylt. Vi har altså brukt en metode som «treffer» i omtrent 95 prosent av tilfellene på lang sikt.
En nyttig huskeregel er: Gjennomsnittet i populasjonen er fast, mens intervallene varierer fra utvalg til utvalg.
Konfidensintervall for vekt på sjokolade: et konkret eksempel
En sjokoladeprodusent har startet produksjonen av en ny sjokoladebar. Vekten på hver bar varierer litt, siden maskiner ikke er perfekte til å fylle formene. En arbeidsleder ved fabrikken vil finne ut hvor mye sjokoladebarene veier i gjennomsnitt. Han ønsker et intervall som med 95 prosent konfidens fanger det sanne gjennomsnittet for vekten.
Det er utgangspunktet for å lage et konfidensintervall for populasjonsgjennomsnittet \mu.
Hva er forskjellen på kjent og ukjent populasjonsstandardavvik?
I praksis møter vi to situasjoner:
- Vi kjenner populasjonsstandardavviket \sigma (svært sjelden i virkeligheten).
- Vi kjenner det ikke, og må estimere det fra utvalget ved hjelp av utvalgsstandardavviket s.
Denne forskjellen bestemmer hvilken fordeling vi bruker til beregningene:
| Situasjon | Standardavvik | Fordeling | Forutsetninger |
|---|---|---|---|
| Kjent σ | Populasjonsstandardavvik σ | Z-fordeling (normalfordelingen) | Uavhengig tilfeldig utvalg; normalfordelt populasjon eller tilstrekkelig god normaltilnærming |
| Ukjent σ | Utvalgsstandardavvik s | t-fordeling (Students t) | Uavhengig tilfeldig utvalg; normalfordelt populasjon for eksakt t-intervall, ofte tilnærming ved store utvalg |
Vi forutsetter et tilfeldig utvalg av uavhengige observasjoner fra samme populasjon. Ved normalfordelte data gjelder Z-metoden med kjent standardavvik og t-metoden med ukjent standardavvik også for små utvalg. Ved store utvalg kan metodene ofte brukes tilnærmet. Det finnes ingen universell n = 30-grense: skjevhet og ekstreme observasjoner har betydning. I sjokoladeeksempelet antar vi normalfordelte vekter.
Formel med kjent varians eller standardavvik (Z-fordeling)
Når vi kjenner populasjonsstandardavviket \sigma, bruker vi denne formelen:
\bar{x}\pm z_{\alpha/2}\cdot\frac{\sigma}{\sqrt{n}}Her betyr:
- \bar{x} = utvalgsgjennomsnittet
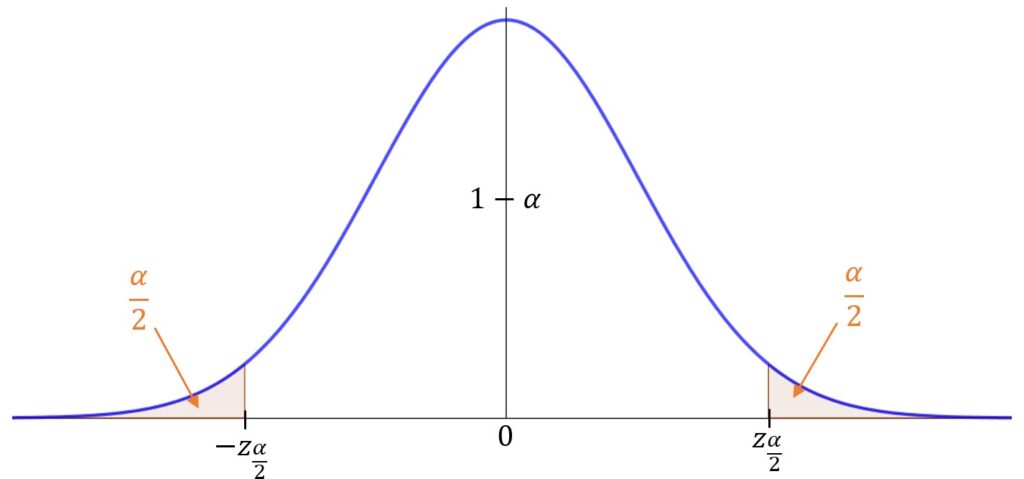
- z_{\alpha/2} = den positive kritiske verdien som har sannsynlighet \alpha/2 til høyre i standardnormalfordelingen. For 95 prosent konfidens er den 1,96. Noen tabeller skriver samme verdi som z_{1-\alpha/2}.
- \sigma = populasjonsstandardavviket
- n = antall observasjoner. Standardfeilen er \sigma/\sqrt{n}. Multipliser standardfeilen med den kritiske verdien for å finne feilmarginen.
Eksempel: sjokoladebarer med kjent standardavvik
Vi har åtte sjokoladevekter: 48,4; 51,0; 49,7; 48,5; 54,2; 53,1; 48,9; 49,3 gram. Gjennomsnittet er \bar{x}=50{,}3875 gram. Vi antar at populasjonsvariansen er kjent: \sigma^2=4 gram², altså \sigma=2 gram. Vi beholder desimalene i mellomregningen og avrunder intervallets grenser til slutt.
Konfidensintervallet med 95 prosent konfidensnivå blir:
\begin{aligned}\text{Standardfeil}&=\frac{2}{\sqrt{8}}\approx0{,}7071\\\text{Feilmargin}&=1{,}96\cdot0{,}7071\approx1{,}3859\\\text{Intervall}&=50{,}3875\pm1{,}3859\\&\approx[49{,}00;\ 51{,}77]\text{ gram}\end{aligned}Det beregnede 95 prosent konfidensintervallet er omtrent 49,00 til 51,77 gram. Ved mange nye tilfeldige utvalg vil metoden gi intervaller som inneholder det sanne gjennomsnittet i omtrent 95 prosent av tilfellene, dersom forutsetningene holder.
Formel med ukjent varians eller standardavvik (t-fordeling)
Når vi ikke kjenner populasjonsstandardavviket, må vi estimere det ved hjelp av utvalgsstandardavviket s. Da bruker vi t-fordelingen:
\bar{x}\pm t_{\alpha/2,n-1}\cdot\frac{s}{\sqrt{n}}Her betyr:
- \bar{x} = utvalgsgjennomsnittet
- t_{\alpha/2,n-1} = den positive kritiske t-verdien med \alpha/2 til høyre og n-1 frihetsgrader
- s = utvalgsstandardavviket
- n = utvalgsstørrelsen
- Frihetsgradene = n-1
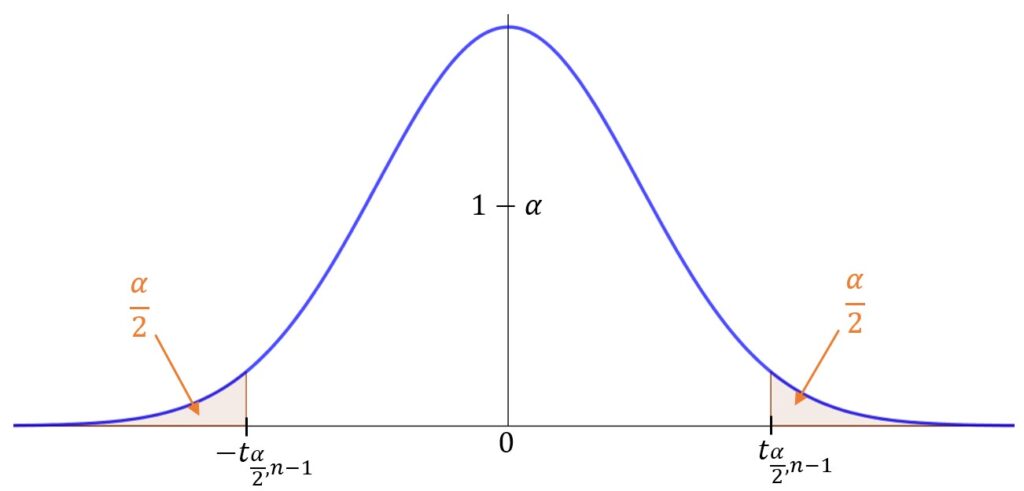
T-fordelingen har tyngre haler enn normalfordelingen, særlig ved få frihetsgrader. Det tar hensyn til usikkerheten ved at standardavviket estimeres.
Hvor kommer formlene fra?
Ved uavhengige normalfordelte observasjoner er Z=(\bar{X}-\mu)/(\sigma/\sqrt{n}) standardnormalfordelt. Når \sigma erstattes med S, følger T=(\bar{X}-\mu)/(S/\sqrt{n}) en t-fordeling med n−1 frihetsgrader.
Vi velger to kritiske grenser med 95 prosent av fordelingen mellom seg. Med kjent standardavvik blir sannsynlighetsuttrykket:
P\left(-z_{\alpha/2}\leq\frac{\bar{X}-\mu}{\sigma/\sqrt{n}}\leq z_{\alpha/2}\right)=1-\alphaNår vi ganger med standardfeilen og ordner ulikheten slik at \mu står i midten, får vi:
\begin{gathered}P\left(\bar{X}-z_{\alpha/2}\frac{\sigma}{\sqrt{n}}\leq\mu\leq\bar{X}+z_{\alpha/2}\frac{\sigma}{\sqrt{n}}\right)\\=1-\alpha\end{gathered}Her er grensene tilfeldige fordi de bygger på et utvalg vi ennå ikke har observert. Etter innsamling setter vi inn det observerte gjennomsnittet. Ved ukjent standardavvik bruker vi samme fremgangsmåte med t-verdien og S/\sqrt{n}.
Eksempel: sjokoladebarer med ukjent standardavvik
Nå antar vi at populasjonsstandardavviket er ukjent. Vi bruker de samme åtte vektene og beregner utvalgsstandardavviket:
Gjennomsnittet er fortsatt \bar{x}=50{,}3875 gram.
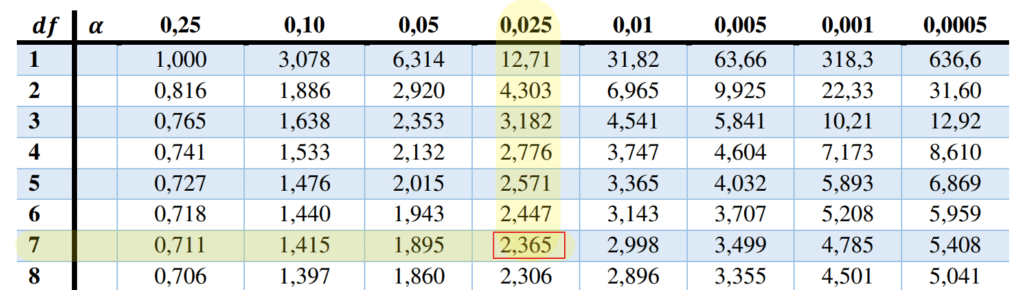
\begin{aligned}s^2&=\frac{\sum_{i=1}^{8}(x_i-50{,}3875)^2}{7}\\&\approx4{,}80696\text{ gram}^2\\s&\approx2{,}19248\text{ gram}\end{aligned}Åtte observasjoner gir sju frihetsgrader. For 95 prosent konfidensnivå er t_{0{,}025,7}\approx2{,}3646.
Konfidensintervallet blir:
\begin{aligned}\text{Standardfeil}&=\frac{2{,}19248}{\sqrt{8}}\approx0{,}77516\\\text{Feilmargin}&=2{,}3646\cdot0{,}77516\approx1{,}83296\\\text{Intervall}&=50{,}3875\pm1{,}83296\\&\approx[48{,}55;\ 52{,}22]\text{ gram}\end{aligned}Her er t-intervallet bredere enn Z-intervallet. Både den større kritiske t-verdien og at utvalgsstandardavviket er litt større enn de antatte 2 grammene, bidrar. Hvis standardfeilen var den samme, ville t-verdien alene gitt et bredere intervall.
Presisjon og konfidensnivå
Med samme datasett blir intervallet bredere når konfidensnivået øker. Metoden dekker det sanne gjennomsnittet oftere, men intervallet blir mindre presist. Vi kan vise forskjellen ved å beregne et 99 prosent t-intervall for de samme sjokoladevektene:
For 99 prosent konfidensnivå og sju frihetsgrader bruker vi t_{0{,}005,7}\approx3{,}4995.
\begin{aligned}50{,}3875&\pm3{,}4995\cdot\frac{2{,}19248}{\sqrt{8}}\\&\approx50{,}3875\pm2{,}71265\\&\approx[47{,}67;\ 53{,}10]\text{ gram}\end{aligned}99 prosent-intervallet, omtrent [47,67; 53,10] gram, er bredere enn 95 prosent-intervallet, [48,55; 52,22] gram. Dette viser avveiingen mellom høyere konfidensnivå og et mer presist intervall.
Hvorfor blir intervallet smalere med større utvalg?
Ved kjent standardavvik og uendret konfidensnivå er feilmarginen proporsjonal med 1/\sqrt{n}. Da gjelder følgende:
- Dobler du utvalgsstørrelsen fra 8 til 16, deles feilmarginen på \sqrt{2}\approx1{,}41.
- Firedobler du utvalgsstørrelsen fra 8 til 32, halveres feilmarginen.
Større utvalg gir vanligvis bedre presisjon. For t-intervaller endres også den kritiske verdien med antall frihetsgrader, og det estimerte standardavviket kan variere mellom utvalg. Derfor er et intervall fra et større, nytt utvalg ikke automatisk smalere.
Kort oppsummert
- Et konfidensintervall uttrykker usikkerheten i et estimat av en populasjonsparameter.
- Konfidensnivået beskriver metoden, ikke sannsynligheten for ett enkelt intervall.
- Kjent standardavvik: Z-fordeling. Ukjent standardavvik: t-fordeling.
- Metodene krever uavhengige observasjoner og passende fordelingsforutsetninger.
- Større konfidensnivå gir bredere intervaller.
- Større utvalg gir vanligvis bedre presisjon når konfidensnivå og spredning ellers er sammenlignbare. Før eksamen kan det også være lurt å lese våre tips til statistikkeksamen.
Ofte stilte spørsmål
Hva betyr egentlig 95 prosent konfidens?
Hva er forskjellen på konfidensintervall og standardfeil?
Når bruker jeg t-fordelingen i stedet for normalfordelingen?
Blir intervallet smalere når utvalget blir større?
Vil du se temaet forklart på video? Se leksjonen Konfidensintervall i kurset Psykologisk forskningsmetode for NTNU.
Vil du se temaet forklart på video? Se leksjonen Konfidensintervall i kurset Psykologisk forskningsmetode for NTNU.
Skal du sammenligne gjennomsnitt i flere grupper, har vi en egen artikkel om variansanalyse (ANOVA).
Finn ditt Statistikk for økonomer-fag tilpasset ditt studiested

MET 2920
Statistikk for økonomer

MET2
Statistikk for økonomer – NHH

MET 3431
Statistikk

MET 1190
Statistikk (siviløkonom)

ØKA1026, 3MET130, SMET130, HMET130
Statistikk for økonomer – Universitetet i Innlandet

BØA115
Statistikk for økonomer – HVL

SFO1100
Statistikk for økonomer – Kristiania

SØK1004, REA1154, AR100219, MET1002
Statistikk for økonomer – NTNU

MET1010
Statistikk for økonomer – USN

HSM103
Statistikk – NLA Høgskolen

ØAMET1100
Statistikk – OsloMet