
Enkel lineær regresjon beskriver sammenhengen mellom en forklaringsvariabel og en responsvariabel med en rett linje. Minste kvadraters metode finner linjen som minimerer summen av de kvadrerte, loddrette avstandene fra punktene til linjen. Vi kan bruke modellen til å beskrive sammenhenger og lage prediksjoner.
Se for deg et koordinatsystem med mange punkter. Hvordan finner du en rett linje som passer med punktene? Og hvordan vet du om linjen passer bra?
Hva er lineær regresjon?
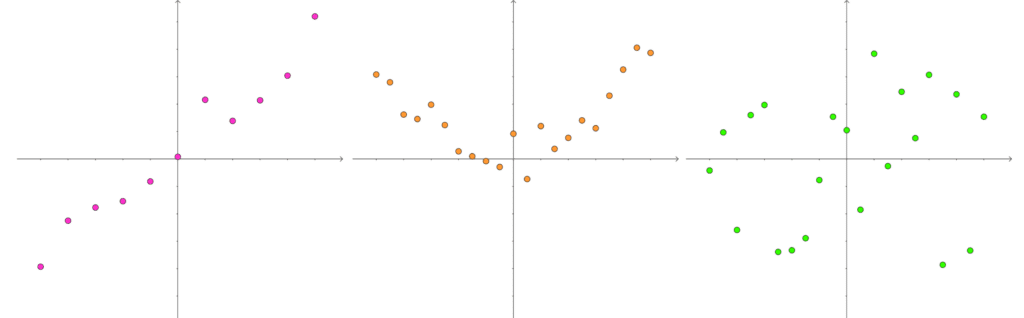
Et datasett kan bestå av en rekke punkter: (x₁, y₁), (x₂, y₂), …, (xₙ, yₙ). En lineær sammenheng betyr at punktene ligger omtrent langs en rett linje. Figuren viser en lineær sammenheng til venstre, en krum sammenheng i midten og punkter uten en tydelig sammenheng til høyre.
Finn linjen som passer best
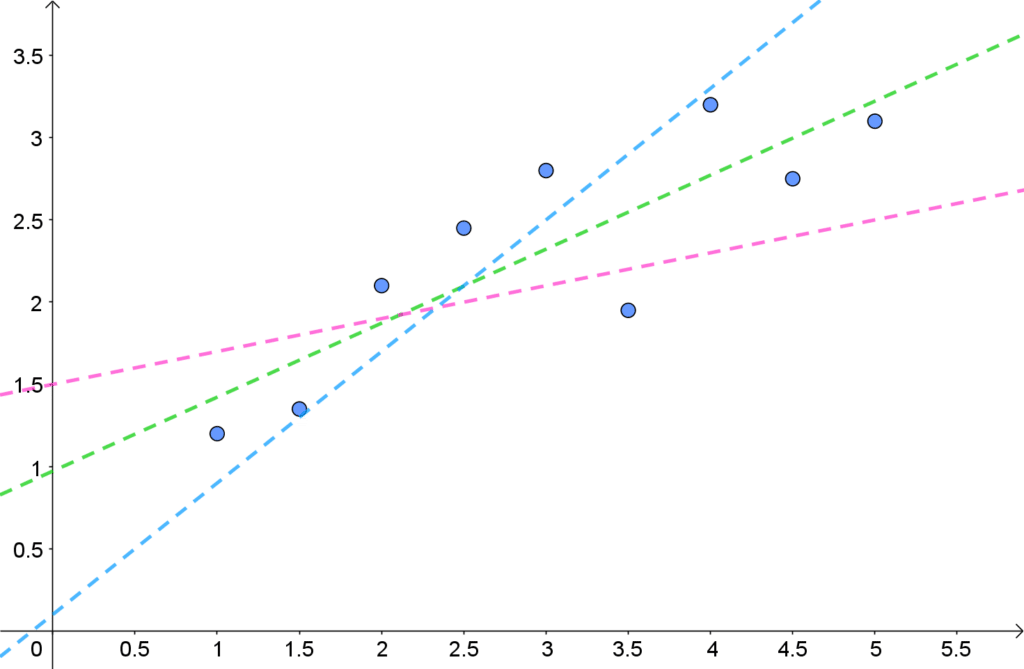
Lineær regresjon handler om å finne en rett linje som passer best mulig med punktene. Flere linjer kan se ut til å passe ganske godt. Minste kvadraters metode gir oss en bestemt regel for å velge mellom dem.
Regresjonsmodellen
Vi skriver den lineære modellen som
Y=\beta_0+\beta_1X+\varepsilon- β₀ er konstantleddet, altså skjæringspunktet med y-aksen.
- β₁ er stigningstallet: endringen i forventet Y når X øker med én enhet.
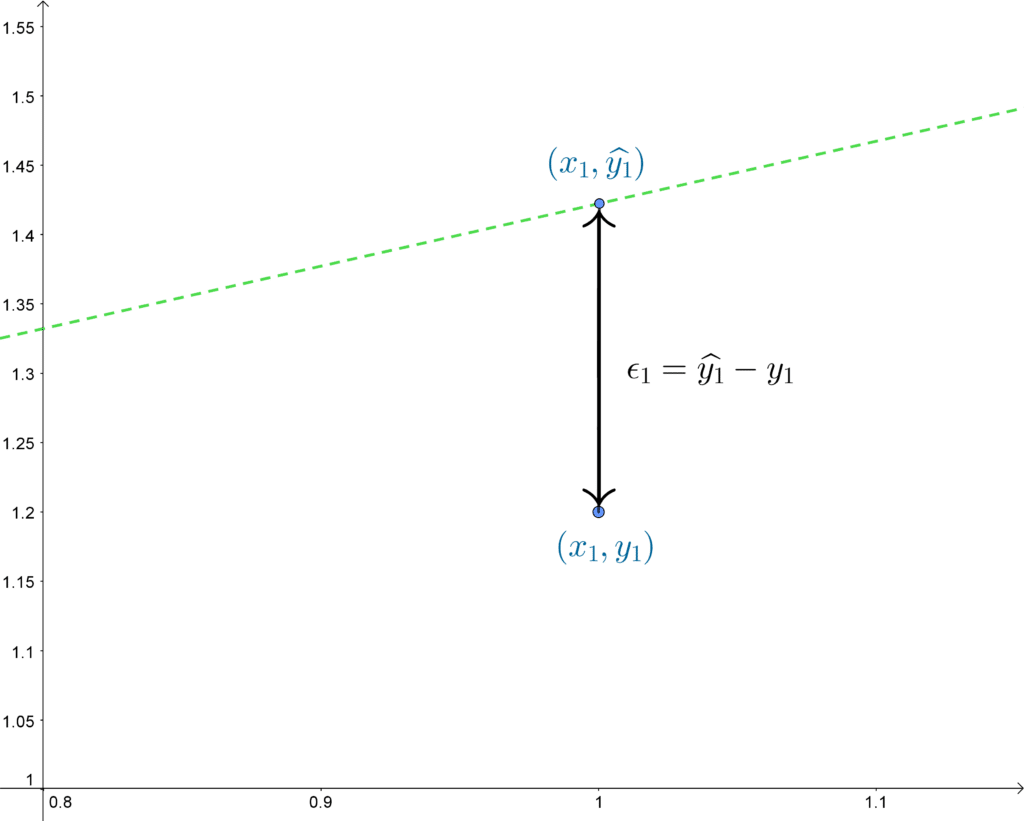
- ε er feilleddet: avviket fra populasjonens forventede Y ved en bestemt X. Det må skilles fra residualen, som vi beregner ut fra den estimerte linjen.
Ut fra dataene estimerer vi koeffisientene. Estimatene kalles \hat{\beta}_0 og \hat{\beta}_1. Den estimerte regresjonslinjen skrives som
\hat{y}=\hat{\beta}_0+\hat{\beta}_1xMinste kvadraters metode
Minste kvadraters metode minimerer summen av de kvadrerte, loddrette avstandene mellom datapunktene og regresjonslinjen. For hver observasjon beregner vi residualen: den observerte y-verdien minus den predikerte verdien på linjen. Metoden velger koeffisientene som gjør summen av de kvadrerte residualene så liten som mulig.
Estimatorene for β₁ og β₀ er:
\hat{\beta}_1=\frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})}{\sum_{i=1}^{n}(x_i-\bar{x})^2} \hat{\beta}_0=\bar{y}-\hat{\beta}_1\bar{x}- \bar{x} og \bar{y} er gjennomsnittet av henholdsvis x og y.
- Nevneren er kvadratsummen S_{xx}=\sum_i(x_i-\bar{x})^2.
- Telleren er kryssproduktsummen S_{xy}=\sum_i(x_i-\bar{x})(y_i-\bar{y}).
Merk: Kvadratsummen S_{xx} er ikke variansen til x. Utvalgsvariansen er S_{xx}/(n-1). Stigningstallet kan også skrives som utvalgskovariansen mellom x og y delt på utvalgsvariansen til x, fordi faktorene n−1 kanselleres. Se også varians og standardavvik for et utvalg.
Eksempel: hvor lang er studenten?
Her er et tenkt datasett med fotlengde og høyde for ti studenter, begge målt i centimeter. Vi vil bruke fotlengden til å predikere høyden. Tallene er laget for å vise beregningen og er ikke hentet fra en undersøkelse.
| Student | Fotlengde (cm) | Høyde (cm) |
|---|---|---|
| 1 | 23 | 170 |
| 2 | 25 | 182 |
| 3 | 24 | 176 |
| 4 | 22 | 165 |
| 5 | 26 | 185 |
| 6 | 24 | 175 |
| 7 | 25 | 180 |
| 8 | 23 | 168 |
| 9 | 27 | 190 |
| 10 | 24 | 177 |
Gjennomsnittene er:
- \bar{x}=24{,}3 cm (gjennomsnittlig fotlengde).
- \bar{y}=176{,}8 cm (gjennomsnittlig høyde).
Først regner vi ut kvadratsummen:
\begin{aligned}S_{xx}&=\sum_{i=1}^{10}(x_i-\bar{x})^2\\&=(23-24{,}3)^2+\cdots+(24-24{,}3)^2\\&=20{,}1\end{aligned}Deretter kryssproduktsummen:
\begin{aligned}S_{xy}&=\sum_{i=1}^{10}(x_i-\bar{x})(y_i-\bar{y})\\&=(23-24{,}3)(170-176{,}8)+\cdots\\&=103{,}6\end{aligned}Nå finner vi stigningstallet:
\hat{\beta}_1=\frac{103{,}6}{20{,}1}\approx5{,}15423Og konstantleddet:
\begin{aligned}\hat{\beta}_0&=176{,}8-\frac{103{,}6}{20{,}1}\cdot24{,}3\\&\approx51{,}55224\end{aligned}Regresjonslinjen blir:
\hat{y}\approx51{,}55224+5{,}15423xI dette tenkte datasettet øker den predikerte høyden med omtrent 5,15 cm for hver centimeter større fotlengde. Det beskriver en sammenheng, ikke at større føtter får en person til å vokse. Ved fotlengde 24 cm gir modellen:
\hat{y}\approx51{,}55224+5{,}15423\cdot24\approx175{,}25\,\mathrm{cm}Konstantleddet gjelder x = 0, som ligger langt utenfor dataene og ikke har en nyttig biologisk tolkning her.
Forutsetninger for regresjon
Vi må skille mellom å beregne regresjonslinjen og å teste koeffisientene eller lage konfidensintervaller rundt dem.
Å finne regresjonslinjen
Selve beregningen krever ingen antakelse om normalfordeling. Men x-verdiene må variere: hvis alle har samme x, er Sₓₓ = 0 og stigningstallet kan ikke bestemmes med denne formelen. At vi kan regne ut en linje, betyr heller ikke at den beskriver dataene godt.
Å teste hypoteser og lage konfidensintervaller
De vanlige t-testene og konfidensintervallene i den klassiske regresjonsmodellen bygger på disse antakelsene:
- Linearitet: Forventet Y ved en gitt X følger en rett linje. Feilleddet har forventning null ved hver X-verdi.
- Uavhengige observasjoner: Hver observasjon er uavhengig av de andre.
- Normalfordelte feil: Feilene ε antas normalfordelte for eksakte tester og intervaller i små utvalg. Residualene brukes til å undersøke om antakelsen virker rimelig.
- Konstant varians (homoskedastisitet): Spredningen rundt populasjonens regresjonslinje er lik ved ulike X-verdier.
Et residualplott kan vise krumming eller om spredningen endrer seg langs linjen. Et Q–Q-plott kan brukes til å vurdere normalitet. Uavhengighet må også vurderes ut fra hvordan dataene er samlet inn; den kan ikke bekreftes av ett plott.
Hvor god er modellen? R²
R², ofte kalt forklart varians, beskriver hvor stor andel av variasjonen i Y modellen fanger opp i datasettet. For vanlig minste kvadraters regresjon med konstantledd ligger R² mellom 0 og 1, så lenge Y varierer. For eksempel:
- R² = 0,9: Modellen fanger opp 90 prosent av variasjonen i Y.
- R² = 0,5: Modellen fanger opp 50 prosent.
- R² = 0,1: Modellen fanger opp 10 prosent.
En høy R² betyr at residualvariasjonen er liten i forhold til den totale variasjonen i Y. Den viser ikke alene at modellen vil predikere nye data godt, eller at X er årsaken til Y. Undersøk også residualene og om modellen gir faglig mening.
Fra én til flere variabler
Så langt har vi sett på enkel lineær regresjon, der Y beskrives ut fra én X. Med flere forklaringsvariabler bruker vi multippel regresjon:
\begin{aligned}Y={}&\beta_0+\beta_1X_1+\beta_2X_2\\&+\cdots+\beta_kX_k+\varepsilon\end{aligned}Multippel regresjon lar oss undersøke sammenhengen med én forklaringsvariabel samtidig som vi tar hensyn til andre målte variabler. Dette kan bidra til å håndtere konfundering, men modellen alene dokumenterer ikke årsakssammenheng. Se videoleksjonen Korrelasjon og kausalitet for mer om skillet.
Kort oppsummert
Enkel lineær regresjon beskriver sammenhengen med en estimert linje. Minste kvadraters metode minimerer summen av de kvadrerte, loddrette residualene. Det estimerte stigningstallet angir hvordan den predikerte Y-verdien endres når X øker med én enhet. Tester og konfidensintervaller krever flere forutsetninger enn selve beregningen. R² beskriver tilpasningen til dataene, men dokumenterer ikke årsakssammenheng.
Se videoleksjonen Enkel regresjon og minste kvadraters metode i kurset Psykologisk forskningsmetode for NTNU.
Ofte stilte spørsmål
Hva er forskjellen på korrelasjon og regresjon?
Hva betyr det at R² er 0,8?
Hva er minste kvadraters metode?
Kan jeg bruke lineær regresjon når sammenhengen ser ut til å være krum?
Hvorfor bruker vi kvadrerte avvik i stedet for bare avvik?
Forskjellen på samvariasjon og årsakssammenheng er et vanlig eksamenstema. Vi har også en egen artikkel om korrelasjon og kausalitet.
Finn ditt statistikkurs

MET 2920
Statistikk for økonomer

MET2
Statistikk for økonomer – NHH

MET 3431
Statistikk

MET 1190
Statistikk (siviløkonom)

ØKA1026, 3MET130, SMET130, HMET130
Statistikk for økonomer – Universitetet i Innlandet

BØA115
Statistikk for økonomer – HVL

SFO1100
Statistikk for økonomer – Kristiania

SØK1004, REA1154, AR100219, MET1002
Statistikk for økonomer – NTNU

MET1010
Statistikk for økonomer – USN

HSM103
Statistikk – NLA Høgskolen

ØAMET1100
Statistikk – OsloMet